Em 22 de setembro de 2026, a OpenAI apresentou o GPT-6 Sol e o GPT-6 Luna. Os novos modelos complementam o GPT-6 Astra com uma proposta que interessa diretamente a quem constrói produtos: executar tarefas de IA com diferentes níveis de capacidade e custo. Segundo a empresa, os preços de API da nova família são aproximadamente 50% menores que os preços promocionais correspondentes do GPT-5.6.
A notícia não é apenas a chegada de dois modelos. Preços menores, melhorias no cache e opções de capacidade permitem repensar o orçamento de assistentes, agentes de programação e aplicações que fazem muitas chamadas de API. Mas economia por token não significa automaticamente economia por tarefa: a qualidade das respostas, o número de tentativas e o tamanho do contexto continuam importando.
GPT-6 Sol e Luna: qual é a diferença?
O Sol foi apresentado como uma opção para trabalho profissional e programação que exigem mais capacidade. O Luna se concentra em eficiência para tarefas frequentes e aplicações em escala. O Astra permanece como o modelo de maior capacidade da família, segundo a OpenAI. Isso cria uma escolha de arquitetura: reservar mais capacidade para etapas difíceis e usar alternativas econômicas quando elas atendem aos critérios de qualidade.
Na API, os identificadores divulgados são gpt-6-sol e gpt-6-luna. Ambos aceitam entrada de texto e imagem e produzem texto pelas APIs Responses e Chat Completions, conforme o histórico oficial da plataforma.
Quanto custa usar os novos modelos?
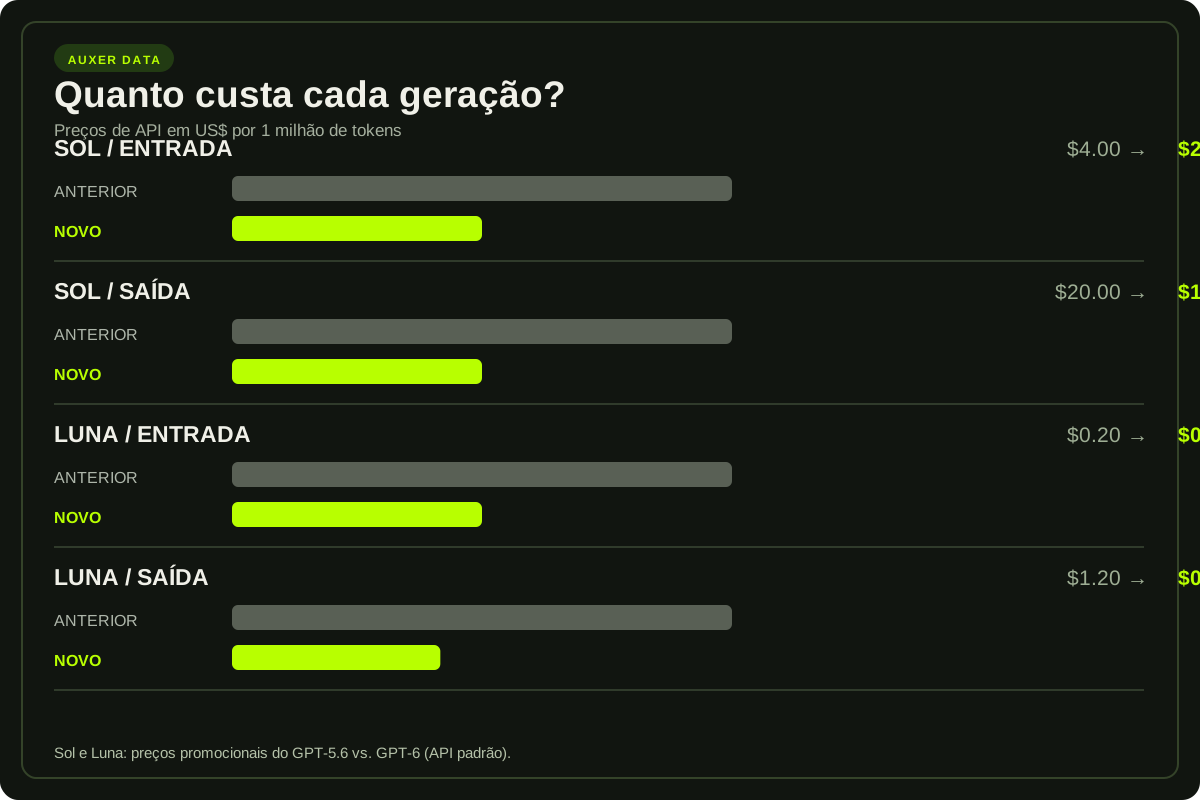
Os preços padrão publicados pela OpenAI para até 272 mil tokens de entrada são os seguintes, em dólares por 1 milhão de tokens:
| Modelo | Entrada | Entrada em cache | Saída |
|---|---|---|---|
| GPT-6 Sol | US$ 2,00 | US$ 0,20 | US$ 10,00 |
| GPT-6 Luna | US$ 0,10 | US$ 0,01 | US$ 0,50 |
Valores da tabela de preços padrão da API divulgados em 22 de setembro. Contextos maiores, gravações em cache e outras modalidades podem ter condições distintas. A redução anunciada compara os novos modelos aos preços promocionais do GPT-5.6, não aos preços de assinaturas do ChatGPT.
Para quem desenvolve, a diferença entre entrada e saída merece atenção. Um agente que lê milhares de linhas de código pode gastar muito com contexto; outro, que gera respostas extensas, pode concentrar o custo nos tokens de saída. Antes de migrar, vale medir a distribuição real de consumo em vez de olhar apenas para o preço de entrada.
O cache pode fazer tanta diferença quanto o novo preço
A OpenAI também anunciou melhorias no prompt caching do GPT-6. Prefixos compartilhados elegíveis, reutilizados em uma janela de 30 minutos, podem aproveitar processamento anterior. A empresa informa desconto de 90% na leitura de tokens de entrada em cache e disponibilizou recursos para acompanhar acertos e diagnosticar falhas de reutilização.
Isso é especialmente relevante para agentes que repetem instruções, definições de ferramentas e partes de uma conversa longa. Em vez de reenviar um contexto quase idêntico sem saber quanto será reaproveitado, a equipe pode verificar as métricas e organizar melhor a estrutura das solicitações.
- Mantenha estáveis os prefixos: instruções e definições de ferramentas que não mudam devem aparecer de maneira consistente.
- Use diagnósticos: uma mudança de modelo, ferramenta ou entrada pode reduzir a reutilização do cache.
- Meça antes de otimizar: acompanhe acertos de cache, latência, custo total e qualidade da resposta no mesmo conjunto de tarefas.
O desconto depende de o cache ser realmente aproveitado. Não se aplica automaticamente a todos os tokens enviados, e a cobrança final depende da composição de cada solicitação.
Uma atualização importante para aplicações com imagens
O changelog oficial registra que, em 25 de setembro, a OpenAI corrigiu um problema de codificação de imagens que prejudicava a compreensão visual do Sol e do Luna. A orientação publicada é repetir avaliações e testar novamente fluxos afetados, especialmente aqueles que usam imagens ou controle de computador. É um lembrete de que benchmarks de lançamento não substituem testes no seu próprio produto.
O que muda para desenvolvedores e empresas?
A possibilidade mais interessante é distribuir o trabalho conforme a dificuldade. Um produto pode experimentar Luna em classificação, extração e respostas rotineiras; Sol em implementação de código e análises mais exigentes; e um modelo mais capaz nas exceções que realmente precisam dele. Esse desenho é uma estratégia de engenharia a ser testada, não uma garantia de que cada modelo será adequado a todas essas tarefas.
Na prática, o próximo passo é criar um conjunto de avaliações com exemplos reais, registrar custo e latência por tarefa e comparar resultados antes de alterar o roteamento. Também convém observar retrabalho, chamadas repetidas e falhas de ferramentas. Um modelo barato que precisa executar a mesma operação várias vezes pode deixar de ser a alternativa mais econômica.
O lançamento do GPT-6 Sol e Luna torna mais acessível experimentar aplicações de IA em escala. Para transformar essa vantagem em um produto sustentável, o diferencial continua sendo uma combinação de avaliação, observabilidade e arquitetura bem pensada.
Fontes
- OpenAI: anúncio do GPT-6 Sol e Luna (22 de setembro de 2026).
- OpenAI API: changelog oficial (lançamento em 22 de setembro e correção visual em 25 de setembro).
- OpenAI: melhorias no cache de prompts do GPT-6 (22 de setembro de 2026).